وب کراولرها (Web crawler) چشم و گوش موتورهای جستوجو هستند؛ برنامههایی هوشمند که با الگوریتمهای پیچیده، صفحات وب را پیمایش کرده، محتوای آنها را استخراج و در پایگاه دادهی موتورهای جستوجو ذخیره میکنند. هر بار که شما عبارتی را در گوگل یا سایر موتورهای جستوجو مینویسید، نتایجی که میبینید حاصل تلاش همین رباتهاست که پیشتر محتوای وب را تحلیل و ایندکس کردهاند.
این ربات خزنده با بررسی مداوم شبکه اینترنت، اطلاعات صفحات را برای موتور جستوجو جمعآوری کرده تا فرآیند مهم ایندکسینگ بهدرستی انجام شود. درک دقیق این مفهوم و تفاوت آن با اسکرپر وب یا وب اسکریپتینگ برای حضور در نتایج جستوجو بسیار اهمیت دارد. اما موضوع حیاتی، درک تاثیر کراولر در سئو و نقش تعیینکنندهی آن در جایگاه سایت شما است. برای شناخت کاربرد Web crawler و انواع آن، ادامهی این مطلب را مطالعه کنید.
Web crawler چیست؟
این ربات خزنده (که گاهی اسپایدر یا عنکبوت وب نیز نامیده میشود)، یک برنامهی نرمافزاری و خودکار است که صفحات مختلف اینترنت را بهشکل سیستماتیک مرور میکند. هدف اصلی این کار، خواندن محتوای سایتها، دنبال کردن لینکهای موجود در آنها و در نهایت، ذخیره و سازماندهی این اطلاعات در پایگاه دادهی بزرگ موتور جستوجو برای انجام صحیح فرآیند ایندکسینگ است.
بسیاری از افراد این مفاهیم را با هم اشتباه میگیرند. برخلاف اسکرپر وب یا تکنیکهای مختلف وب اسکریپتینگ که تمرکزشان بر استخراج دادههای خاص و هدفمند (مثل قیمت رقبا یا اطلاعات تماس) برای پردازشهای بعدی است، یک وب کراولر رسالت بسیار گستردهتری دارد. او نقشهی ساختاری کل اینترنت را رسم میکند تا دسترسی به اطلاعات برای کاربران نهایی امکانپذیر شود.
شیوه کار ربات خزنده و الگوریتمهای آن
با درک دقیق Web crawler، بررسی فرآیندها و نحوهی کارکرد آن جذابتر میشود. این برنامهها کار خود را با یک لیست اولیه از آدرسهای اینترنتی معتبر (Seed URLs) آغاز میکنند. هر وب کراولر پس از ورود به این صفحات، کدهای HTML را میخواند و تمام لینکهای داخلی و خارجی موجود را استخراج کرده و برای بررسیهای بعدی در یک صف انتظار (URL Frontier) قرار میدهد.
برای مدیریت این حجم بزرگ از دادهها در بستر اینترنت، موتور جستوجو از الگوریتمهای هوشمندی بهره میبرد. الگوریتمهای پیمایش (مانند الگوریتم جستوجوی سطح اول یا BFS) به Web Crawler کمک میکنند تا ساختار اصلی سایتها را درک کرده و ابتدا صفحات مهمتر را مورد بررسی قرار دهد. همچنین، الگوریتم تازگی (Freshness) با بررسی دورهای تعیین میکند که یک خزندهی وب با چه فرکانس و فاصلهی زمانی باید برای یافتن محتواهای جدید به سایت بازگردد. بنابراین این رباتها موظفاند کل ساختار وب را بدون ایجاد بار ترافیکی سنگین روی سرور سایتها تحلیل کنند.
اهمیت Web Crawler در سئو و سرعت رتبهبندی
این عملکرد دقیق و سیستماتیک، بهطور مستقیم روی جایگاه سایت شما در نتایج جستوجو اثر میگذارد. در حقیقت، حیاتیترین کاربرد Web crawler، پل زدن میان محتوای متنی یا تصویری شما و پایگاه دادهی موتورهای جستوجو است. اگر فرآیند خزش بهدرستی و با سرعت بالا انجام نشود، مرحلهی نهایی یعنی ایندکسینگ هرگز اتفاق نمیافتد.
تاثیر کراولر در سئو بهقدری بالا است که حتا با داشتن بهترین محتوای ممکن، تا زمانی که توسط این برنامهها دیده نشوید، شانسی برای رقابت نخواهید داشت. فرقی نمیکند کدام یک از انواع Web crawler (مثل خزندههای دسکتاپ، موبایل یا خزندههای اخبار) سایت شما را بررسی کنند؛ در هر شکل سرعت پاسخگویی سرور یک فاکتور تعیینکننده در تخصیص بودجهی خزش (Crawl Budget) است.
برای درک بهتر میزان تاثیر زیرساخت بر عملکرد این رباتها، به جدول مقایسهای زیر توجه کنید.
| رفتار ربات خزنده در سایت | نتیجه نهایی در ایندکسینگ و رتبهبندی | وضعیت زیرساخت و سرعت سایت |
| استفاده حداکثری از بودجهی خزش و بررسی سریع صفحات عمیق | ثبت سریع تغییرات، درک بهتر ساختار و بهبود چشمگیر جایگاه | سایت بهینهشده با زیرساخت ابری قدرتمند |
| ترک زودهنگام سایت جهت جلوگیری از اختلال در سرور | افت شدید رتبه و نادیده گرفته شدن محتواهای جدید و ارزشمند | سرور کند، ناپایدار و دارای قطعی مکرر |
به همین دلیل است که کارشناسان فنی همواره بر پایداری هاستینگ تاکید دارند. انتخاب یک بستر پرسرعت مانند خرید سرور ابری مطمین، میتواند خیالتان را راحت کند که رباتها بدون مواجه شدن با خطاهای سروری، تمام صفحات سایت شما را با موفقیت میبینند.
کاربرد Web crawler
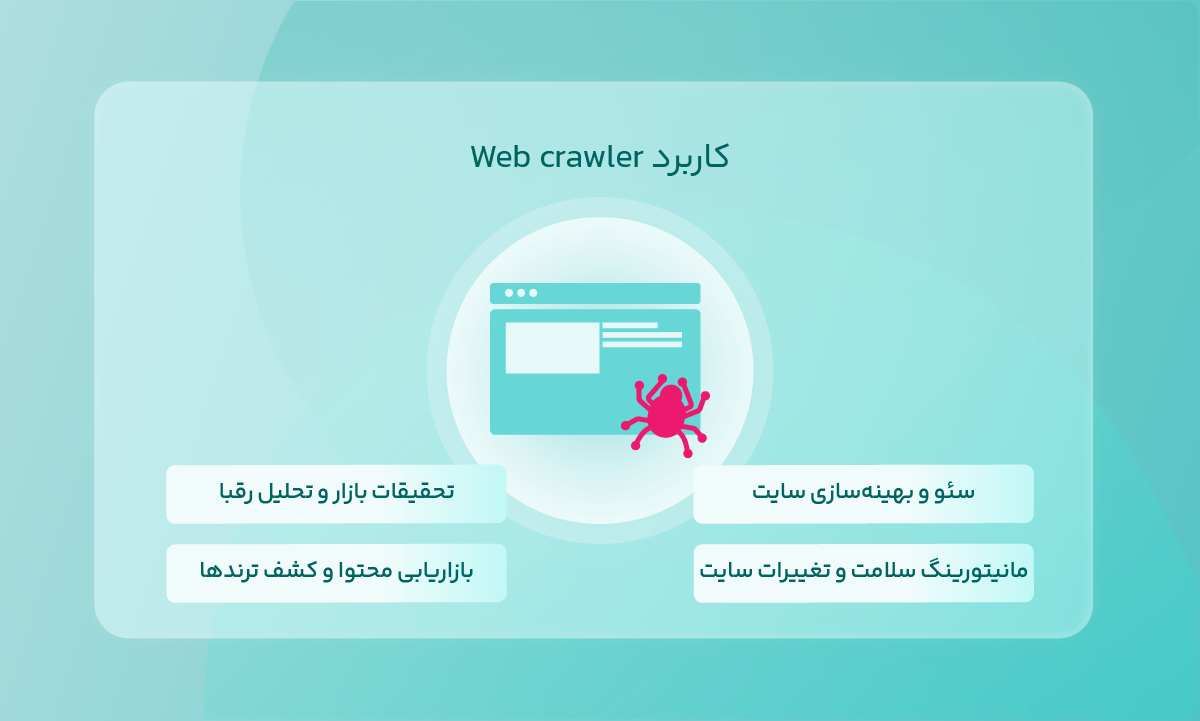
این برنامههای هوشمند فراتر از یک ابزار ساده برای جستوجو عمل میکنند. برای آشنایی بیشتر با کاربرد Web crawler و تاثیر آن در رشد کسبوکارتان، پیشنهاد میکنیم ادامهی این بخش را با دقت بخوانید.
1. سئو و بهینهسازی سایت
اصلیترین وظیفهی یک ربات خزنده، کمک به موتور جستوجو برای شناخت دقیق صفحات شما است تا فرآیند ایندکسینگ بدون خطا انجام شود. با سنجش و بهبود شاخصهای Core Web Vitals، میتوانید سرعت صفحات را برای استقبال بهتر از این رباتها بهینهسازی کنید و رتبه خود را ارتقا دهید.
2. تحقیقات بازار و تحلیل رقبا
بسیاری از سرویسهای پیشرفتهی تحلیل بازار، در واقع بر پایهی تکنولوژی Web Crawler بنا شدهاند. این ابزارها با پیمایش هزاران صفحه در سطح وب، به کسبوکارها کمک میکنند تا فراتر از یک اسکرپر وب ساده عمل کرده و تغییرات کلان قیمت یا موجودی کالاها را در کل بازار رصد کنند.
3. مانیتورینگ سلامت و تغییرات سایت
رصد مداوم پایداری زیرساخت و بررسی سلامت لینکها، یکی دیگر از وظایف انواع Web crawler است. این ابزارها با شناسایی خطاهای سروری (مثل ارور ۵۰۰) یا لینکهای شکسته، به مدیران سایت یاری میرساند تا قبل از افت رتبه، مشکلات فنی را برطرف کنند.
4. بازاریابی محتوا و کشف ترندها
این خزندهی وب با پایش مستمر کلیدواژهها، موضوعات داغ و رفتار کاربران در سطح وب به تیمهای محتوا کمک میکند تا نیازهای واقعی مخاطب را کشف کرده و تقویم محتوایی خود را هدفمندتر بچینند.
این ابزارهای قدرتمند برای تجزیه و تحلیل دادههای بزرگ وب و بررسی سایت شما، به یک بستر ارتباطی سریع و بدون تاخیر نیاز دارند. با استفاده از زیرساختهای ابری مدرن و خرید CDN معتبر، میتوانید سرعت پاسخدهی سایت به درخواستهای Web Crawler را در سراسر جهان بهینه کرده و خیالتان را از بابت حضور همیشگی در نتایج راحت کنید.
تفاوت کراولینگ و ایندکسینگ
اکنون که با مهمترین موارد کاربرد Web crawler آشنا شدیم، زمان آن رسیده تا به یکی از پرتکرارترین ابهامات سئو پاسخ دهیم: تفاوت کشف اطلاعات با ذخیرهسازی آنها. برای درک بهتر این موضوع که نقش دقیق یک ربات خزنده در کمک به موتور جستوجو چیست و فرآیند خزش چه تفاوتی با ثبت نهایی صفحات دارد، پیشنهاد میکنیم به جدول مقایسهای زیر نگاهی بیندازید.
| ویژگی و کارکرد | کراولینگ (خزش یا Crawling) | ایندکسینگ (فهرستبندی یا Indexing) |
| تعریف و ماهیت | فرآیند کشف، گشتوگذار و خواندن کدهای صفحات جدید یا بهروزشده در بستر اینترنت | پردازش، سازماندهی و ذخیرهی اطلاعات کشفشده در دیتابیس برای پاسخگویی به کاربران |
| عامل اجرایی | انواع وب کراولر و خزندهی وب (مانند روباتهای گوگل یا بینگ) | هستهی مرکزی پردازش و پایگاه داده بزرگ موتورهای جستوجو |
| نقش کلیدی در سئو | قدم اول؛ تضمین دیده شدن سایت و محتوای شما توسط Web Crawler | قدم نهایی؛ امکانپذیر کردن نمایش سایت شما در نتایج جستوجوی کلمات کلیدی |
| تفاوت با سایر مفاهیم | عملکردی متفاوت از یک اسکرپر وب دارد و هدف صرفن درک ساختار است، نه استخراج دیتای خاص | فراتر از کدهای وب اسکریپتینگ عمل میکند و هدف آمادهسازی دیتابیس برای رتبهبندی است |
همانطور که در جدول میبینید، Web crawler تنها قطعهی اول پازل است. بدون خزش موفق، دیتایی ثبت نمیشود و بدون فهرستبندی، تمام زحمات شما بینتیجه خواهد ماند. بنابراین، با میزبانی سایت روی زیرساختهای ابری پایدار و پرسرعت، مسیر را برای ورود انواع Web crawler هموار کنید تا بالاترین بازدهی را از تاثیر کراولر در سئو بهدست آورید.
انواع Web crawler

شناخت انواع وب کراولر به شما کمک میکند تا بدانید هر ربات خزنده با چه هدفی وارد سایت شما میشود و چگونه بر تجربهی کاربری اثر میگذارد. برای درک تفاوتهای ساختاری میان یک خزندهی وب تجاری با ابزارهای تخصصیتر، توضیحات زیر را دنبال کنید.
1. کراولر عمومی (General-Purpose Crawler)
اینها معروفترین نمونههای Web Crawler هستند که توسط غولهایی مثل گوگل و بینگ مدیریت میشوند. هدف اصلی آنها پیمایش کل اینترنت برای فرآیند ایندکسینگ و نمایش نتایج در موتور جستوجو است.
2. کراولر بکلینک (Backlink Crawler)
این ابزارها (مثل رباتهای Ahrefs یا SEMrush) برخلاف یک اسکرپر وب معمولی، تمرکز خود را بر تحلیل شبکه پیوندها گذاشتهاند. آنها با پایش مداوم لینکهای ورودی و خروجی، قدرت دامنه و تاثیر کراولر در سئوی رقابتی را میسنجند تا استراتژیهای لینکسازی را تحلیل کنند.
3. کراولر مدیا (Media Crawler)
این نوع از ربات خزنده بهطور اختصاصی برای شناسایی و فهرستبندی فایلهای غیرمتنی مثل تصاویر و ویدیوها طراحی شده است. بهینهسازی ویژگیهایی مثل متن جایگزین (Alt Text) برای این خزندهها اهمیت دارد.
4. کراولر محتوا و متمرکز (Focused Crawler)
این خزندهها برای نفوذ به بخشهای خاصی از وب یا موضوعات محدود (مثل سایتهای خبری یا قیمتگذاری) طراحی شدهاند. عملکرد آنها شباهت زیادی به فرآیند وب اسکریپتینگ دارد، با این تفاوت که بهجای استخراج ساده، بهدنبال درک عمیقتر از تغییرات محتوایی و کاربرد Web crawler در تحلیل ترندها هستند.
در نهایت، تفاوت در اهداف این رباتها باعث میشود که هر کدام رفتار متفاوتی با بودجهی خزش سایت شما داشته باشند. با فراهم کردن یک زیرساخت فنی استاندارد، میتوانید میزبانی شایستهای از تمامی این خزندهها داشته باشید و اعتبار سایت خود را در فضای وب تضمین کنید.
تفاوت وب کراولینگ و وب اسکریپتینگ
اگرچه هر دو مفهوم شامل تعامل خودکار با وبسایتها هستند، اما مرز باریکی میان آنها وجود دارد. Web Crawler با هدف اکتشاف و نقشهبرداری، بهشکل سیستماتیک از یک صفحه به صفحهی دیگر میرود تا ساختار کلی را درک کند. در حالی که اسکرپرهای وب با هدفی متمرکز و با استفاده از تکنیکهای وب اسکریپتینگ، تنها بهدنبال استخراج دادههای خاص و دقیق (مانند قیمت یک محصول یا ایمیلهای یک لیست) از دل صفحات هستند.
به زبان ساده، اولی بهدنبال این است که «چه صفحاتی در وب وجود دارد» تا به موتور جستوجو در فرآیند ایندکسینگ کمک کند، اما دومی بهدنبال «چه اطلاعاتی درون این صفحهی خاص است» تا از آن برای تحلیلهای تجاری بهره ببرد. بنابراین اگر قصد بهبود جایگاه سایت را دارید، باید روی بهینهسازی برای خزندهی وب تمرکز کنید و اگر بهدنبال جمعآوری دیتای رقبا هستید، ابزارهای اسکریپینگ چارهی کار شما است.
جمعبندی
در این مقاله بهطور کامل بررسی کردیم که Web crawler چگونه با پیمایش هوشمندانهی خود، پایه و اساس موتور جستوجو را برای نمایش دقیقترین نتایج شکل میدهد. فرآیند ایندکسینگ به عملکرد صحیح یک خزندهی وب وابسته است و بدون در نظر گرفتن جایگاه کراولر در سئو، رسیدن به رتبههای برتر گوگل غیرممکن خواهد بود.
همچنین، در این مطلب با تفاوتهای ساختاری میان وب کراولر و ابزارهایی مثل اسکرپر وب آشنا شدیم و دانستیم که برخلاف تکنیکهای وب اسکریپتینگ که بر استخراج محدود دادهها تمرکز دارند، هدف اصلی انواع Web crawler، درک ساختار کلی و ارزشگذاری محتوای شما محسوب میشود. با توجه به گسترش کاربرد وب کراولر در دنیای آنلاین، بهینهسازی زیرساختهای فنی برای میزبانی از این رباتها یک ضرورت است.