دیتا پلتفرم نسل جدیدی از بستر مدیریت داده است که بهشکل مدیریتشده، فرآیند پردازش و تحلیل دادهها را انجام میدهد. به زبان ساده، دیتا پلتفرم یا پلتفرم داده راهکاری نوآورانه برای تیمهای فنی و مهندسان داده است که امکان جمعآوری، پردازش، پاکسازی، ذخیرهسازی و تحلیل دادهها را بدون دردسرهای پیچیدهی زیرساخت فراهم میکند. برخلاف سیستمهای قدیمی که مستلزم پیادهسازی ETLهای سنگین بودند، در این بستر بسیاری از فرآیندها خودکار و آمادهی استفاده هستند.
رشد دادههای تراکنشی، لاگها، رویدادهای کاربری و اطلاعات رفتاری باعث شد که معماریهای سنتی پاسخگوی نیازهای تحلیلی امروز نباشند و دیتا پلتفرم به عنوان هستهی اصلی مدیریت دادههای کلان مطرح شود. این راهکار با تکیه بر Object Storage و معماری Lakehouse، هم ذخیرهسازی دادهها را مقرونبهصرفه میکند و هم اتصال سریع به ابزارهای BI را ممکن میسازد.
اگر میخواهید بدانید پلتفرم داده (Data Platform) چگونه میتواند موتور محرک رشد کسبوکارتان باشد، در ادامهی مطلب همراه ما باشید.
دیتا پلتفرم چیست؟
دیتا پلتفرم یک سیستم جامع و مدیریتشده برای جمعآوری، پردازش، پاکسازی، ذخیرهسازی و تحلیل دادههاست. این پلتفرم بهگونهای طراحی شده که دادهها را از منابع مختلف دریافت کرده و آنها را برای تحلیل آماده میکند. در دیتا پلتفرم دادهها در قالب Iceberg Table ذخیره میشوند و کاربران میتوانند با استفاده از SQL آنها را تحلیل کنند. وجود موتورهایی مانند Trino باعث میشود کوئرینویسی روی حجم بزرگی از دادهها با سرعت بالا انجام شود. این رویکرد، تفاوت اصلی پلتفرم داده با معماریهای سنتی Data Warehouse را نشان میدهد.
در واقع، در این معماری نیازی به پیادهسازی ETL پیچیده یا نگهداری یک انبار دادهی جداگانه وجود ندارد. دیتا پلتفرم به عنوان یک پلتفرم دادهی یکپارچه، تمام این مراحل را در یک بستر واحد پوشش میدهد.
تفاوت دیتا پلتفرم با Data Warehouse یا انبار داده
در نگاه کلی، Data Warehouse یک سیستم ایستا و سنگین است که برای تحلیل دادههای ساختارمند استفاده میشود و به ETLهای پیچیده و هزینهبر نیاز دارد. این سیستم هزینهی بالایی دارد و برای تغییر مقیاس یا فرمت داده انعطاف کمی نشان میدهد.
اما دیتا پلتفرم با حذف این مراحل، هزینهی پیادهسازی را کاهش داده و انعطافپذیری بالاتری ارایه میکند. برخلاف انبار دادهی سنتی، این سیستم با تکیه بر معماری Lakehouse امکان ذخیرهسازی داده در فرمتهای متنوع را فراهم میسازد. شما میتوانید هر نوع دادهای (ساختارمند یا بدون ساختار) را در دیتا پلتفرم ذخیره و تحلیل کنید. همچنین، نیاز به ETLهای پیچیده را حذف کرده و تحلیل داده را مستقیمن روی Object Storage ممکن میکند.
برای تحلیل بیگ دیتا، انتخاب دیتا پلتفرم منطقیتر بهنظر میرسد؛ زیرا هم از نظر هزینه بهینهتر عمل میکند و هم توسعهپذیری بیشتری دارد. برای درک بهتر مفهوم دادههای کلان و اهمیت آن در تحلیلهای امروزی، پیشنهاد میکنیم مقالهی بیگ دیتا چیست را مطالعه کنید تا با ابعاد مختلف آن آشنا شوید.
ویژگیهای دیتا پلتفرم
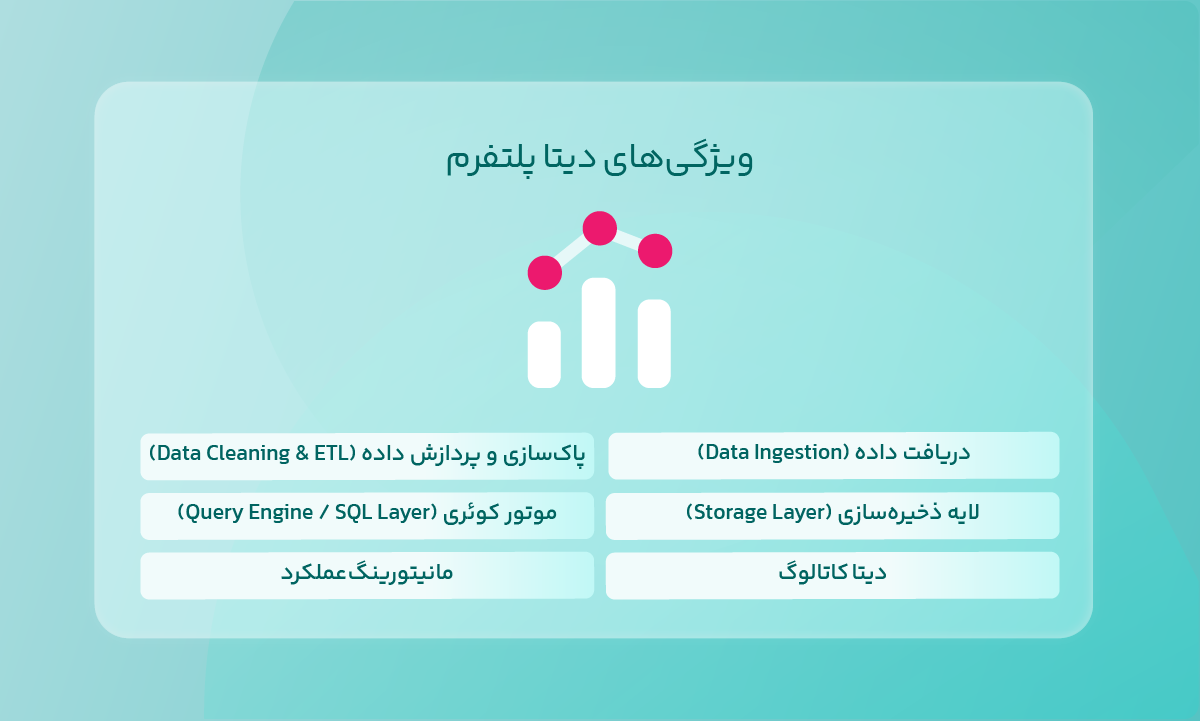
هنگامی که دربارهی ویژگیهای پلتفرم داده صحبت میکنیم، در واقع به مجموعهای از قابلیتهای end-to-end اشاره داریم که کل چرخهی عمر داده را پوشش میدهند. پلتفرم داده مجموعهای از قابلیتهای پیشرفته و مدرن را در قالب یک محصول یکپارچه ارایه میدهد که در ادامه به آنها اشاره میکنیم.
1. دریافت داده (Data Ingestion)
این بخش مسوول جمعآوری دادهها از منابع متنوع است. دیتا پلتفرم دادهها را از APIها، فایلها، دیتابیسها و لاگها دریافت میکند و اتصال مستقیم به سرویسهای آروانکلاد امکان یکپارچهسازی سریع و امن دادهها را فراهم میسازد. همچنین، استفاده از ابزارهای Fluentd مدیریت جریانهای داده را ساده میکند و قابلیت زمانبندی (Scheduling) اجازه میدهد دادهها بهشکل دورهای و منظم جمعآوری و پردازش شوند.
2. پاکسازی و پردازش داده (Data Cleaning & ETL)
دادههای جمعآوریشده قبل از تحلیل نیازمند پاکسازی و استانداردسازی هستند. در این مرحله، فرآیندهای پاکسازی مانند حذف دادههای تکراری، اعمال قوانین اعتبارسنجی، نرمالسازی و غنیسازی دادهها (Enrichment) انجام میشود. همچنین، Schema Enforcement تضمین میکند که ساختار دادهها در طول زمان ثابت و منظم باقی بماند. این فرآیندها هم برای دادههای لحظهای (real-time) و هم دادههای دورهای (Batch) اجرا میشوند و نیاز به ایجاد ETL پیچیده را از بین میبرند.
3. لایه ذخیرهسازی (Storage Layer)
پس از پاکسازی، دادهها در قالب آپاچی آیسبرگ روی آبجکت استوریج ذخیره میشوند. این لایه از قابلیتهای Snapshot و Versioning پشتیبانی میکند تا نسخههای مختلف دادهها در دسترس باشند. ویژگی Time Travel امکان بازگشت به وضعیت گذشتهی دادهها را فراهم میسازد. ذخیرهسازی روی Object Storage علاوه بر مقیاسپذیری نامحدود، هزینهها را کاهش داده و نیاز به Data Warehouse سنتی را حذف میکند.
4. موتور کوئری (Query Engine / SQL Layer)
موتور Trino امکان اجرای مستقیم کوئریهای SQL روی دادهها را فراهم کرده و کاربران میتوانند بهسادگی با ابزارهای BI مانند PowerBI ،Tableau ،Superset و Grafana به دادهها متصل شوند. کوئریها مستقیمن روی آبجکت استوریج اجرا شده و پردازش همزمان و دورهای (real-time و Batch) بدون انتقال دادهها امکانپذیر است.
5. دیتا کاتالوگ
دیتا کاتالوگ اطلاعات کامل درباره دادهها، ساختار آنها و دسترسی کاربران را در یکجا جمعآوری میکند. این بخش امکان یافتن سریع دادهها، جلوگیری از تکرار عملیات و حفظ حاکمیت دادهها را فراهم میسازد. همچنین با رصد مسیر حرکت دادهها، گزارش کاملی از کوئریها ثبت میشود تا شفافیت و امنیت دادهها امن بماند.
6. مانیتورینگ عملکرد
تمام pipelineها و فرآیندهای دیتا پلتفرم بهطور کامل مانیتور میشوند. متریکهایی مانند مصرف منابع، خطاها و تاخیرها در دسترس هستند و گزارشهای Audit برای کوئریها به ثبت میرسد. این بخش کمک میکند هرگونه مشکل شناسایی و رفع شود و کارایی سیستم همیشه بهینه باقی بماند.
نقش Apache Iceberg در دیتا پلتفرم
آپاچی آیسبرگ یکی از فناوریهای کلیدی در این پلتفرم است و ذخیرهسازی دادهها در قالب جدول Iceberg مزایای متعددی ایجاد میکند. این فرمت ذخیرهسازی نهتنها از Snapshot و Time Travel پشتیبانی میکند، بلکه امکان Schema Evolution (تغییر ساختار داده در طول زمان) را هم دارد. قابلیت Snapshot امکان مشاهدهی وضعیت داده در زمانهای مختلف را فراهم میسازد و Time Travel به تحلیلگران اجازه میدهد به نسخههای قبلی داده دسترسی داشته باشند.
با استفاده از آپاچی آیسبرگ میتوانید دادههای قدیمی را بازیابی کنید و کوئریهایی دقیقتر بنویسید. این قابلیتها باعث میشوند دیتا پلتفرم در مقایسه با فرمتهای قدیمی، انعطافپذیری بیشتری ارایه دهد.
شیوه عملکرد دیتا پلتفرم
پلتفرم داده با استفاده از معماری Lakehouse و فناوریهایی مانند Apache Spark ،Trino و Iceberg فرآیندها را اجرا میکند. عملکرد آن از چند مرحلهی اصلی تشکیل میشود. ابتدا دادهها از منابع مختلف جمعآوری شده و سپس فرآیند پاکسازی و استانداردسازی روی آنها انجام میگیرد.
در مرحلهی بعد، ذخیرهی دادهها در جدول آیسبرگ انجام میشود و آمادهی تحلیل خواهند بود. کاربران از طریق SQL و موتور Trino به دادهها کوئری میزنند و نتایج را در ابزارهای BI مشاهده میکنند. این زنجیرهی یکپارچه باعث میشود مسیر داده از Collect تا Query بدون وقفه طی شود. در ادامه، نحوهی عملکرد این سیستم را بهطور خلاصه مشاهده میکنید:
- دریافت دادهها از منابع مختلف (API، فایل، دیتابیس)
- پاکسازی و نرمالسازی دادهها بدون نیاز به کدنویسی دستی
- ذخیرهسازی دادهها در قالب Iceberg Tables روی آبجکت استوریج
- اجرای کوئریهای SQL با موتور اختصاصی Trino
- اتصال دادهها به ابزارهای BI مانند PowerBI و Superset
مزایای دیتا پلتفرم
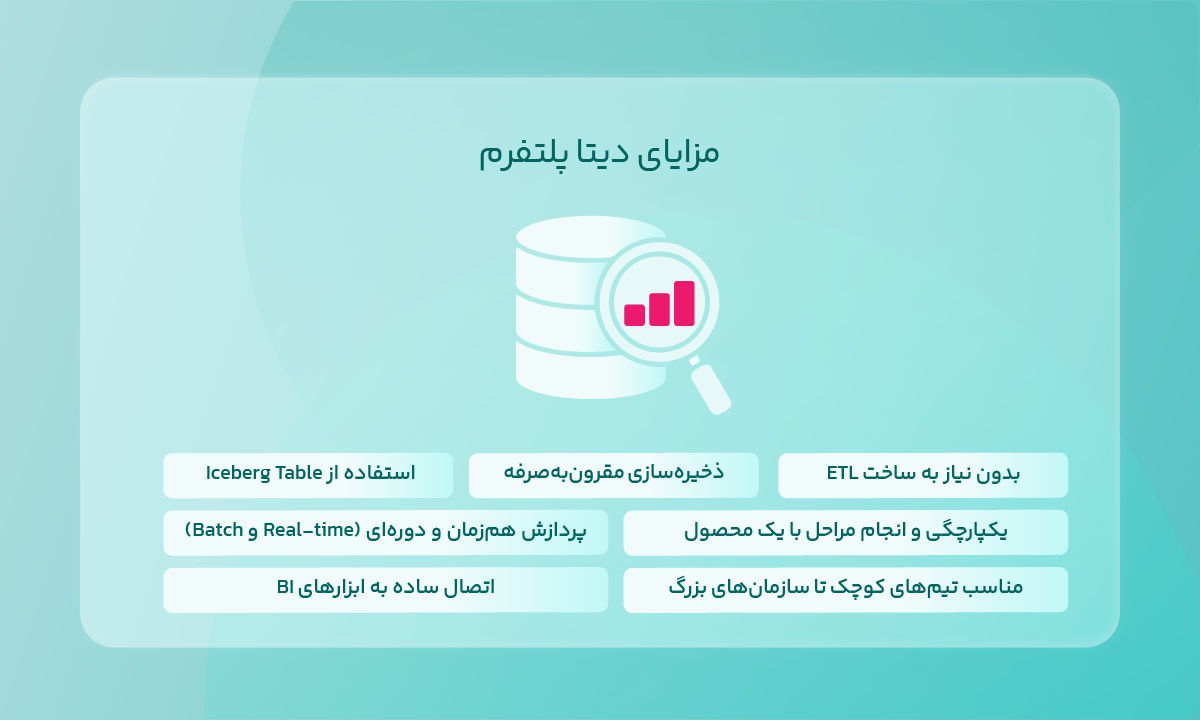
استفاده از دیتا پلتفرم چندین مزیت مهم برای سازمانها دارد که روند کار با دادهها را سریع، ساده و مقرونبهصرفه میکند. در ادامه به این مزایا اشاره میکنیم.
1. بدون نیاز به ساخت ETL
در دیتا پلتفرم تمام مراحل مدیریت دادهها بهشکل خودکار انجام میشود. در این سیستم دادهها جمعآوری (Collect)، پاکسازی (Clean)، تبدیل (Transform)، ذخیره (Store) و آمادهی تحلیل (Query) میشوند؛ بدون اینکه تیم شما نیاز به طراحی و نگهداری ETLهای پیچیده داشته باشد.
2. ذخیرهسازی مقرونبهصرفه
دیتا پلتفرم از Object Storage آروانکلاد استفاده میکند و نیازی به Data Warehouse بزرگ و پرهزینه ندارد. این روش علاوه بر کاهش هزینه، مقیاسپذیری بالا و انعطاف در ذخیرهسازی دادهها را هم تضمین میکند.
3. استفاده از Iceberg Table
فرمت Iceberg امکانات پیشرفتهای ارایه میدهد که مدیریت دادهها را آسانتر میکند. ویژگیهایی مانند Snapshot ،Time Travel و Schema Evolution به شما اجازه میدهد به نسخههای قدیمی دادهها دسترسی داشته باشید، تغییرات را پیگیری و دادهها را بدون مشکل تحلیل کنید. علاوهبر این، فرآیند بهشکل ACID-like انجام میگیرد تا همهی تراکنشها دقیق و بدون خطا پردازش شوند.
4. یکپارچگی و انجام مراحل با یک محصول
تمام مراحل از جمعآوری دادهها تا تحلیل و اتصال به ابزارهای BI با یک محصول انجام میشود. این یکپارچگی نیاز به چندین سیستم مختلف و انتقال دادهها بین آنها را از بین میبرد و سرعت کار را افزایش میدهد.
5. مناسب تیمهای کوچک تا سازمانهای بزرگ
استفاده از دیتا پلتفرم نیاز به تیم مهندس داده یا تیم DevOps تخصصی ندارد. حتا تیمهای کوچک هم میتوانند دادههای خود را بهراحتی مدیریت و تحلیل کنند و سازمانهای بزرگ هم بدون پیچیدگی زیرساختی از آن بهره ببرند.
6. پردازش همزمان و دورهای (Real-time و Batch)
این محصول از معماری Spark + Iceberg استفاده میکند و اجازه میدهد دادهها هم بهشکل لحظهای و هم دستهای پردازش شوند. این انعطاف به سازمانها کمک میکند در تحلیل دادههای بزرگ و متنوع عملکرد بهتری داشته باشند.
7. اتصال ساده به ابزارهای BI
دیتا پلتفرم امکان اتصال سریع و مستقیم به ابزارهای محبوب هوش تجاری مانند PowerBI ،Tableau، Superset ،Grafana و Trino Client را فراهم میسازد. همچنین، اتصال از راه ODBC و JDBC امکان استفاده از هر نرمافزار تحلیلی دیگر را هم مهیا میکند.
کاربردهای دیتا پلتفرم
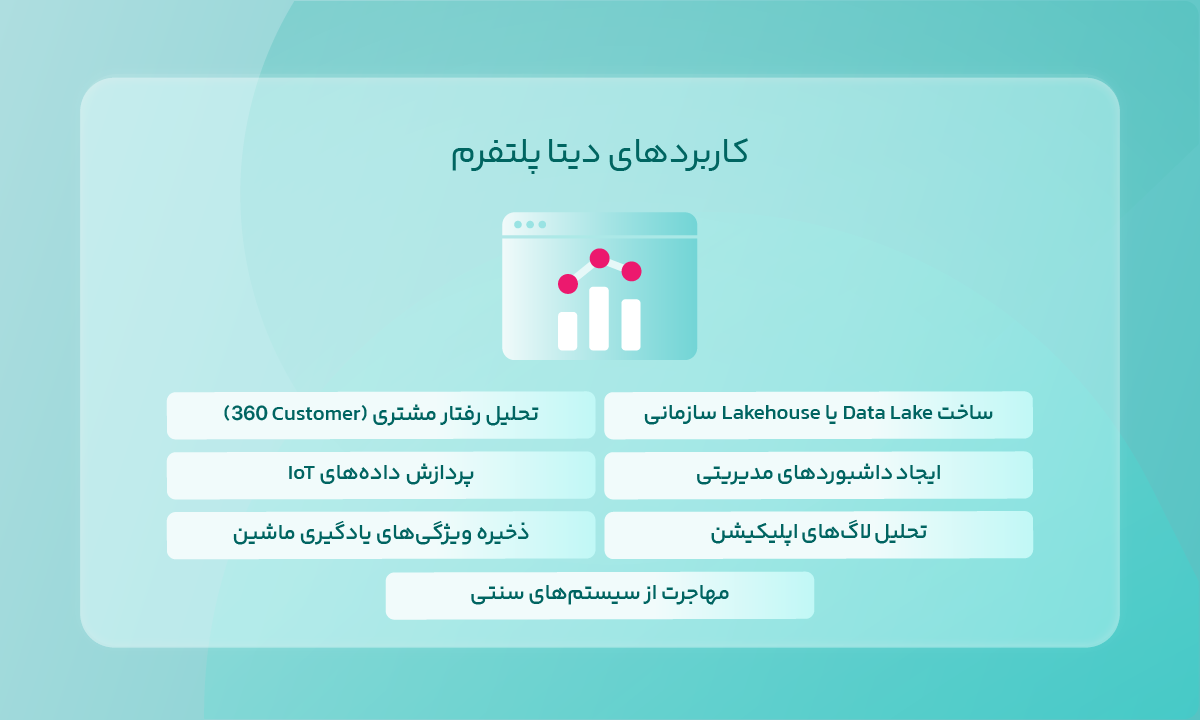
پلتفرم داده کاربردهای متنوعی در سازمانها دارد و به کسبوکارها کمک میکند از دادههای خود به بهترین شکل استفاده کنند. در ادامه مهمترین کاربردهای آن را بررسی میکنیم.
1. ساخت Data Lake یا Lakehouse سازمانی
سازمانها میتوانند یک مخزن مرکزی برای دادههای کلان خود بسازند. این مخزن برای بانکها، فینتکها، کسبوکارهای e-commerce و هر سازمان دادهمحوری مناسب است و امکان ذخیره و مدیریت حجم بسیاری از دادهها را فراهم میکند.
2. ایجاد داشبوردهای مدیریتی
با دیتا پلتفرم میتوان بدون نیاز به راهاندازی یک انبار دادهی کامل، داشبوردهای مدیریتی در ابزارهایی مثل PowerBI یا Superset ایجاد کرد. این روش تحلیل دادهها را ساده و سریع میکند و اطلاعات مورد نیاز مدیران را به شکل تصویری و واضح ارایه میدهد.
3. تحلیل رفتار مشتری (Customer 360)
دیتا پلتفرم امکان ترکیب دادهها از منابع مختلف را بدون ایجاد ETLهای سنگین فراهم میسازد. این قابلیت کمک میکند تا تصویر کاملی از رفتار و تعامل مشتریان با محصولات و خدمات سازمان بهدست آید و تصمیمگیریهای استراتژیک دقیقتر انجام شود.
4. پردازش دادههای IoT
برای دستگاهها و حسگرهای IoT، دادهها بهشکل لحظهای جمعآوری و پردازش و در قالب آیسبرگ ذخیره میشوند. این روش حجم بالای دادهها را بدون کند شدن سیستم مدیریت کرده و تحلیلها را در همان زمان ممکن میسازد.
5. تحلیل لاگهای اپلیکیشن
دادههای لاگ نرمافزارها و اپلیکیشنها میتوانند مستقیمن از آبجکت استوریج پردازش شوند. این کار بررسی عملکرد سیستم، تشخیص خطا و بهینهسازی اپلیکیشنها را ساده و سریع میکند.
6. ذخیره ویژگیهای یادگیری ماشین
دیتا پلتفرم امکان ذخیرهسازی ویژگیهای مدلهای یادگیری ماشین را همراه با ثبت snapshot و تاریخچهی تغییرات فراهم میسازد. این قابلیت کمک میکند تیمهای داده بهراحتی مدلها را آموزش دهند و تغییرات دادهها را دنبال کنند.
7. مهاجرت از سیستمهای سنتی
سازمانها میتوانند ETL Server و انبار دادههای پرهزینه را با دیتا پلتفرم جایگزین کنند. این کار هزینهها را کاهش میدهد، مدیریت دادهها را ساده میکند و سرعت تحلیل دادهها را بالا میبرد.
مقایسه با دیگر راهکارهای مشابه
در بازار جهانی، راهکارهایی مانند AWS Glue ،Databricks Lakehouse و Snowflake Snowpipe وجود دارند. با این حال، دیتا پلتفرم آروانکلاد مزایای رقابتی مشخصی ارایه میدهد.
سهولت استفاده در این پلتفرم بالاتر است؛ زیرا نیاز به دانش تخصصی بیگدیتا ندارد. از نظر هزینه نیز در مقایسه با نمونههای خارجی اقتصادیتر عمل میکند. در جدول زیر تفاوت این راهکارها را مشاهده میکنید:
| ویژگی | دیتا پلتفرم آروانکلاد | AWS Glue | Databricks Lakehouse |
| سهولت استفاده | بسیار ساده، نیازی به دانش تخصصی بیگ دیتا ندارد | نیاز به دانش فنی و تنظیمات پیچیده | نیاز به تخصص در Databricks و Spark |
| هزینه | مقرونبهصرفه، مبتنی بر Object Storage | پرهزینه، بهویژه برای حجم بالای داده | پرهزینه، نیاز به زیرساختهای بزرگ |
| زیرساخت | دیتاسنتر ایرانی، مناسب کسبوکارهای داخلی | دیتاسنتر خارجی، محدود به مناطق AWS | دیتاسنتر خارجی، محدود به مناطق پشتیبانی شده |
| نیاز به ETL | ندارد، همهچیز خودکار است | نیاز به طراحی ETL | نیاز به طراحی ETL و Data Pipeline |
| ذخیرهسازی | Object Storage + Iceberg Tables | S3 + Glue Catalog | Delta Lake / Lakehouse |
| پردازش Real-time | همزمان Real-time و Batch | عمدتن Batch | Real-time و Batch با پیکربندی |
| اتصال به ابزارهای BI | ساده و مستقیم (PowerBI ،Tableau ،Grafana) | امکان اتصال با نیاز به تنظیمات | اتصال با ODBC/JDBC و ابزارهای BI |
| مقیاسپذیری | بالا و بدون محدودیت | بالا ولی هزینهی بالاتر | بالا ولی هزینه و پیچیدگی بیشتر |
در واقع، دیتا پلتفرم یک نسخهی ساده، مقرونبهصرفه و متناسب با نیازهای داخلی از Lakehouseهای پیشرفته جهانی است.
کاهش هزینههای زیرساخت داده با دیتا پلتفرم
در معماریهای سنتی، ساختن Pipelineهای ETL، نگهداری انبار داده، سرورهای سنگین و تیم DevOps هزینههای بالایی ایجاد میکند. اما دیتا پلتفرم با تکیه بر آبجکت استوریج و حذف نیاز به ساختارهای سنتی، این هزینهها را به حداقل میرساند.
همچنین، با استفاده از قابلیتهایی مانند Scheduling ،Snapshot و Stream Processing، بهرهوری تیمها بالا رفته و نیاز به منابع انسانی تخصصی کم میشود.
چگونه میتوان از دیتا پلتفرم آروانکلاد استفاده کرد؟
برای استفاده از دیتا پلتفرم آروانکلاد نیازی به راهاندازی زیرساخت پیچیده وجود ندارد و استفاده از آن بسیار ساده است. کاربران میتوانند از یکی از مسیرهای زیر دادههای خود را وارد کنند:
- فایلهای CSV، JSON یا Excel
- APIهای خارجی یا داخلی
- اتصال به دیتابیسها
سپس، دادهها بهشکل خودکار پاکسازی شده و در Iceberg Tableها ذخیره میشوند. کاربران میتوانند با استفاده از ابزارهای تحلیلی محبوب مانند PowerBI ،Grafana یا Superset مستقیمن به دادهها متصل شوند و تحلیلهای موردنظرشان را انجام دهند.
جمعبندی
دیتا پلتفرم به عنوان یک راهکار مدرن، سریع، مقیاسپذیر و مقرونبهصرفه تحولی در مدیریت و تحلیل دادههای کلان ایجاد کرده است. این سیستم با حذف مراحل پیچیدهی ETL و عدم نیاز به انبار دادهی مستقل، هزینهها را کاهش داده و سرعت تحلیل داده را بالا میبرد.
اگر سازمان شما به دنبال یک راهکار مدرن برای تحلیل بیگ دیتا است، پلتفرم دادهی آروانکلاد انتخابی هوشمندانه خواهد بود. چرا که مسیر استفادهی موثر از دادهها را برایش ما ساده، سریع و مقرونبهصرفه میکند.