LLM یا مدل زبانی بزرگ، نوعی مدل هوش مصنوعی است که الگوهای زبان را از حجم زیادی از داده میآموزد. این مدل میتواند پرسشها را پاسخ دهد، متن تولید کند، محتوا را ترجمه یا خلاصه کند و در نوشتن کد کمک بگیرد. در ادامه، نحوهی عملکرد، انواع، کاربردها، مزایا و محدودیتهای LLM را بررسی میکنیم.
LLM چیست؟
LLM کوتاهشدهی عبارت Large Language Model و به معنی «مدل زبانی بزرگ» است. مدل زبانی احتمال قرار گرفتن واژهها یا بخشهای یک متن در کنار یکدیگر را محاسبه میکند و براساس الگوهای آموختهشده، پیشبینی ادامهی متن را انجام میدهد. گوگل نیز مدل زبانی را مدلی میداند که احتمال حضور یک توکن یا دنبالهای از توکنها را در یک توالی محاسبه میکند.
مدل زبانی بزرگ همین کار را در مقیاسی گسترده انجام میدهد. این مدل با دادههای بیشتر، شبکهی عصبی بزرگ و تعداد زیادی پارامتر آموزش میبیند. پارامترها مقادیر عددی درون شبکه هستند که هنگام آموزش تنظیم میشوند. چنین مقیاسی به LLM امکان میدهد روابط پیچیدهی زبان را تشخیص داده و چند کار متفاوت را انجام دهد. اگر قصد دارید قابلیتهای مدلهای زبانی و دیگر مدلهای AI را در پروژههای خود به کار بگیرید، میتوانید از سرویس هوش مصنوعی آروانکلاد استفاده کنید.
واژهی «بزرگ» عدد ثابتی ندارد و تعریف آن با پیشرفت فناوری تغییر میکند. مقیاس، دادهی آموزشی و گسترهی تواناییها در کنار هم یک LLM را تعریف میکنند.
LLM چگونه کار میکند؟
عملکرد LLM بر تبدیل زبان به عدد و پیشبینی واحد بعدی متن استوار است. مدل ابتدا ورودی را به بخشهای کوچکتری به نام توکن تقسیم میکند. هر توکن میتواند یک واژه، بخشی از واژه یا یک نشانه باشد. سپس، مدل توکنها را به نمایشهای عددی تبدیل میکند تا شبکهی عصبی رابطهی میان آنها را پردازش کند.
در مرحلهی آموزش، مدل نمونههای فراوانی از متن را میبیند و بارها توکن بعدی را پیشبینی میکند. الگوریتم، فاصلهی پیشبینی با پاسخ درست را میسنجد و وزنهای شبکه را تغییر میدهد. تکرار این فرآیند به مدل کمک میکند الگوهای دستوری، ارتباط مفاهیم و سبکهای نوشتاری را بیاموزد.
هنگام استفاده، کاربر یک پرامپت یا ورودی میفرستد. مدل برای توکن بعدی چند احتمال میسازد و یکی را انتخاب میکند. این فرآیند تا تکمیل پاسخ ادامه دارد. بنابراین، مدل پاسخ را از یک پایگاه دادهی ثابت برنمیدارد، بلکه آن را براساس الگوهای آموختهشده تولید میکند.
محصول مبتنیبر LLM به رابط کاربری، API و پایگاه داده نیز نیاز دارد. برای میزبانی این بخشها، خرید سرور ابری میتواند در برنامهی استقرار قرار بگیرد.
نقش ترنسفورمر در LLM
ترنسفورمر نوعی معماری شبکهی عصبی است که پژوهشگران آن را در مقالهی «Attention Is All You Need» معرفی کردند. این معماری رابطهی میان بخشهای مختلف متن را بررسی میکند و امکان پردازش موازی دادهها را فراهم میسازد. چنین قابلیتی آموزش مدلهای بزرگ را عملیتر کرده است.
Attention یا توجه، بخش اصلی این معماری است. این سازوکار اهمیت هر توکن را در ارتباط با توکنهای دیگر میسنجد. برای مثال، مدل میتواند ارتباط یک ضمیر را با اسمی که چند واژهی قبل آمده است تشخیص دهد. این قابلیت به حفظ زمینه و درک رابطه میان بخشهای متن کمک میکند.
انواع LLM براساس معماری

مدلهای زبانی مبتنیبر ترنسفورمر براساس اجزای معماری در سه گروه اصلی قرار میگیرند. هر گروه روش متفاوتی برای دریافت ورودی و ساخت خروجی دارد.
۱. مدلهای فقط رمزگذار یا Encoder-only
مدل فقط رمزگذار، متن ورودی را میخواند و برای هر بخش آن یک نمایش وابسته به زمینه میسازد. این ساختار برای درک و دستهبندی متن، تحلیل احساسات، استخراج اطلاعات و جستوجوی معنایی مناسب است.
BERT نمونه شناختهشدهی این معماری است. این مدل متن را بهشکل دوسویه بررسی میکند و برای درک هر واژه، اطلاعات قبل و بعد از آن را در نظر میگیرد.
۲. مدلهای فقط رمزگشا یا Decoder-only
مدل فقط رمزگشا خروجی را توکن به توکن تولید میکند. هر توکن تازه براساس ورودی و توکنهای قبلی شکل میگیرد. این ساختار برای تولید متن، پاسخگویی، گفتوگو، خلاصهسازی و برنامهنویسی کاربرد دارد.
خانوادهی GPT نمونهی معروف این معماری است. بسیاری از LLMهای مولد نیز از همین الگو یا نسخههای توسعهیافتهی آن استفاده میکنند.
۳. مدلهای رمزگذار و رمزگشا یا Encoder-Decoder
در این معماری، رمزگذار ورودی را پردازش میکند و رمزگشا با استفاده از نتیجهی آن، خروجی را میسازد. این ساختار برای کارهایی مناسب است که یک دنباله باید به دنبالهای دیگر تبدیل شود.
ترجمهی ماشینی، بازنویسی و خلاصهسازی از کاربردهای رایج این گروه هستند. T5 نمونهای از این معماری است که وظایف پردازش زبان طبیعی را در قالب تبدیل متن به متن تعریف میکند.
تفاوت LLM و ترنسفورمر
LLM و ترنسفورمر دو مفهوم جدا هستند. LLM مدلی است که در مقیاس بزرگ آموزش میبیند و زبان را پردازش یا تولید میکند. ترنسفورمر معماری شبکهی عصبی است و روش پردازش اطلاعات را مشخص میسازد. تفاوتهای اصلی این دو مفهوم را در جدول زیر میبینید:
| معیار | LLM | ترنسفورمر |
| تعریف | مدل زبانی بزرگی که با حجم زیادی از داده آموزش میبیند | معماری شبکهی عصبی برای پردازش ارتباط میان دادهها |
| وظیفه | درک زبان، تولید متن، پاسخگویی، ترجمه و انجام وظایف زبانی | پردازش توکنها و تشخیص ارتباط میان آنها با سازوکار توجه |
| مقیاس | اغلب پارامترها و دادههای آموزشی زیادی دارد | در مدلهای کوچک و بزرگ کاربرد دارد |
| کاربرد | ساخت چتبات، ابزار تولید محتوا، مترجم و دستیار برنامهنویسی | ساخت مدلهای زبانی، بینایی ماشین و دیگر سامانههای یادگیری عمیق |
| رابطه با یکدیگر | بسیاری از LLMهای جدید بر پایهی ترنسفورمر ساخته میشوند | زیرساخت معماری بسیاری از LLMها را تشکیل میدهد |
کاربردهای LLM
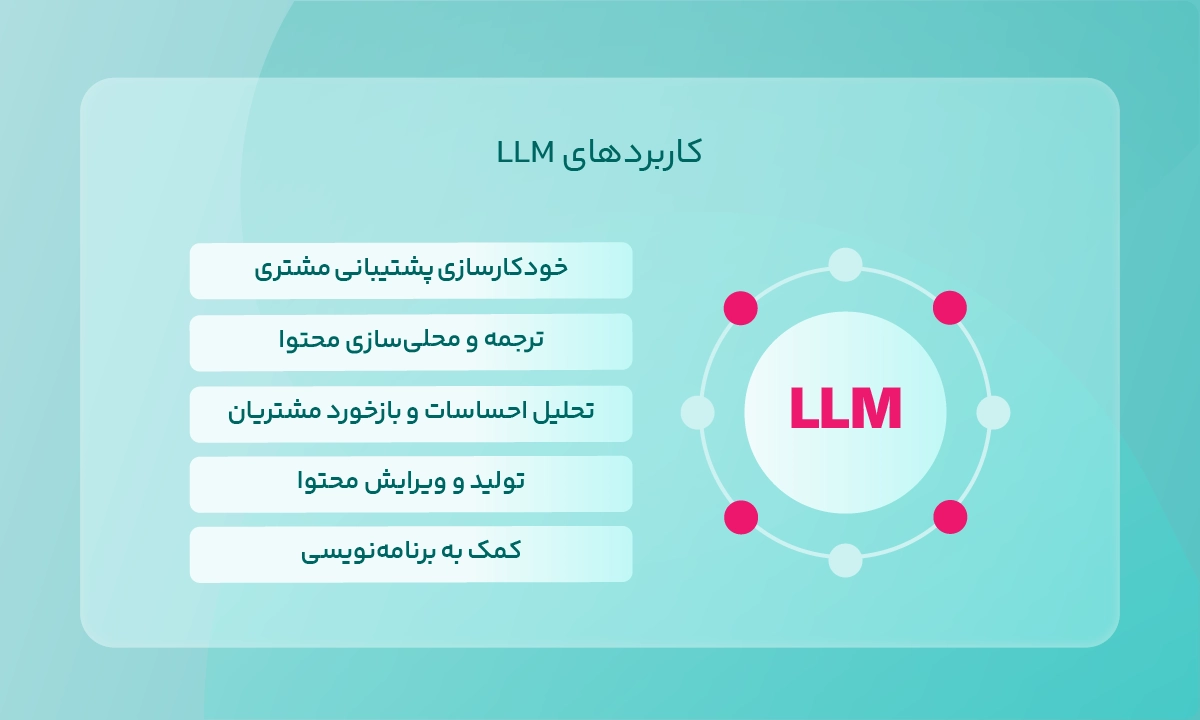
مدلهای زبانی بزرگ در بسیاری از خدمات دیجیتال و فرآیندهای سازمانی کاربرد دارند. در این بخش مهمترین کاربردهای LLM را بررسی میکنیم.
۱. خودکارسازی پشتیبانی مشتری
LLM میتواند پرسش مشتری را تشخیص دهد، پاسخ اولیه تولید کند و درخواست را به واحد مناسب بفرستد. این مدل همچنین از اطلاعات موجود در پایگاه دانش برای پاسخگویی به پرسشهای پرتکرار استفاده میکند.
۲. ترجمه و محلیسازی محتوا
مدل زبانی بزرگ متن را از زبانی به زبان دیگر ترجمه میکند. در محلیسازی، مدل میتواند لحن، اصطلاحات و ساختار محتوا را با زبان و فرهنگ مخاطب مقصد هماهنگ کند.
۳. تحلیل احساسات و بازخورد مشتریان
LLM دیدگاههای مثبت، منفی و خنثی را در نظرها، پیامها و نظرسنجیها تشخیص میدهد. این مدل همچنین موضوعهای پرتکرار و دلایل رضایت یا نارضایتی مشتریان را از میان بازخوردها استخراج میکند.
۴. تولید و ویرایش محتوا
تهیهی پیشنویس، خلاصه کردن اسناد، بازنویسی متن و پیشنهاد عنوان از کاربردهای LLM در تولید محتوا هستند. بررسی خروجی مدل از نظر درستی اطلاعات، لحن و هماهنگی با هدف محتوا همچنان ضرورت دارد.
۵. کمک به برنامهنویسی
مدل زبانی بزرگ میتواند کد پیشنهاد دهد، خطا را تشریح کند و برای توابع یا بخشهای مختلف نرمافزار مستندات بنویسد. ساخت آزمون نرمافزاری و توضیح کدهای موجود نیز از دیگر کاربردهای آن است.
کسبوکارها برای استفاده از LLM همیشه به آموزش مدل اختصاصی نیاز ندارد. خرید سرویس هوش مصنوعی میتواند دسترسی به مدلهای آماده را از راه API فراهم سازد. در این روش، تیم توسعه مدل را به نرمافزار متصل میکند و براساس میزان مصرف از آن بهره میگیرد.
مزایا و ویژگیهای LLM
LLMها با درک زبان طبیعی، ارتباط میان کاربر و نرمافزار را سادهتر میکنند و میتوانند چندین وظیفهی زبانی را با یک مدل انجام دهند. این مدلها با حفظ زمینهی مکالمه، پاسخها را براساس اطلاعات قبلی مرتبطتر تولید میکنند و در کارهایی مانند تولید، خلاصهسازی و دستهبندی محتوا به کار میروند.
یکی دیگر از مزایای LLMها، سرعت در توسعه و امکان شخصیسازی است. توسعهدهندگان میتوانند از این مدلها برای ساخت سریع نمونههای اولیه بهره ببرند و پاسخها یا عملکرد مدل را براساس نیاز کاربران و سازمان تنظیم کنند.
چالشهای LLM
استفاده عملی از LLM به ارزیابی خروجی، کنترل دسترسی و نظارت نیاز دارد. مهمترین چالشهای این مدلها عبارتاند از:
- احتمال تولید اطلاعات نادرست یا توهم مدل
- بازتاب سوگیریهای موجود در دادههای آموزشی
- محدود بودن دانش به دادهها و زمان آموزش
- هزینهی پردازشی بالا برای آموزش و اجرا
- پیچیدگی تنظیم مدل برای حوزههای تخصصی
- خطر افشای اطلاعات حساس و نقض حریم خصوصی
تیمهایی که قصد دارند یک مدل زبانی بزرگ را بهشکل محلی اجرا یا تنظیم کنند، اغلب برای تامین توان پردازشی سراغ خرید سرور GPU میروند. پیش از خرید، باید نوع مدل، حافظه گرافیکی موردنیاز، تعداد کاربران و حجم پردازش پروژه را مشخص کرد.
مدلهای زبانی بزرگ معروف

هر مدل معروف، خانوادهای از نسخهها و قابلیتها را شامل میشود. در ادامه، کاربرد عمومی این خانوادهها را توضیح دادهایم.
GPT .۱
خانواده مدلهای OpenAI برای تولید متن، پاسخگویی، تحلیل، برنامهنویسی و پردازش ورودیهای چندرسانهای است. این خانواده در نسخههای مختلف توسعه پیدا کرده و برای کاربردهای متنوعی از چتبات و تولید محتوا تا استدلال و پردازش کد استفاده میشود. قابلیتها و عملکرد هر نسخه با توجه به مدل و ابزارهای در دسترس آن متفاوت است.
۲. Gemini
از خانوادهی گوگل است و نسخههای آن میتوانند متن، تصویر، صدا، ویدیو و سند را پردازش کنند. این مدلها برای کارهایی مانند پاسخگویی، تحلیل اطلاعات، تولید محتوا و برنامهنویسی به کار میروند. برخی نسخههای جمنای نیز برای پردازش حجم بسیاری از اطلاعات و کار با ورودیهای طولانی طراحی شدهاند.
۳. Claude
مدلهای Anthropic برای گفتوگو، تحلیل اسناد، تولید متن و برنامهنویسی است. این مدلها میتوانند اطلاعات موجود در اسناد و متنهای طولانی را تحلیل و براساس آن پاسخ تولید کنند. Claude در کاربردهایی مانند تحلیل محتوا، خلاصهسازی، تولید متن و کمک به توسعهدهندگان استفاده میشود.
۴. Grok
خانوادهی مدلهای xAI برای گفتوگو، برنامهنویسی و کار با ابزارهاست. این مدلها میتوانند در پاسخگویی، تحلیل متن، تولید محتوا و اجرای برخی وظایف با کمک ابزارهای خارجی به کار گرفته شوند. قابلیتهای Grok بسته به نسخهی مدل و ابزارهای متصل به آن تغییر میکند.
۵. DeepSeek
این خانواده مدلهایی برای گفتوگو، استدلال و برنامهنویسی دارد و از راه API نیز در دسترس است. برخی مدلهای دیپسیک برای انجام وظایف پیچیدهی استدلالی و تولید کد طراحی شدهاند. توسعهدهندگان میتوانند از مدلهای این خانواده در نرمافزارها و سرویسهایی که به قابلیتهای زبانی و استدلالی نیاز دارند استفاده کنند.
جمعبندی
LLM مدلی مبتنیبر یادگیری عمیق است که الگوهای زبان را از حجم بسیاری از داده میآموزد و براساس ورودی کاربر خروجی میسازد. ترنسفورمر و شبکههای عصبی در ساخت بسیاری از مدلهای زبانی بزرگ نقش دارند. این مدلها در پشتیبانی مشتری، ترجمه، تولید محتوا، تحلیل بازخورد و برنامهنویسی استفاده میشوند.
انتخاب مدل به نوع داده، دقت، هزینه، سرعت، حریم خصوصی و شیوهی راهاندازی بستگی دارد. استفاده از API برای بسیاری از پروژهها کافی است. اجرای مستقل نیز به منابع پردازشی مناسب احتیاج دارد.